DocsPerformances
Performances
Un téléphone n'est pas un serveur. La vitesse dépend de la taille du modèle, du backend et de la mémoire qui reste pour la conversation.
CPU ou Vulkan
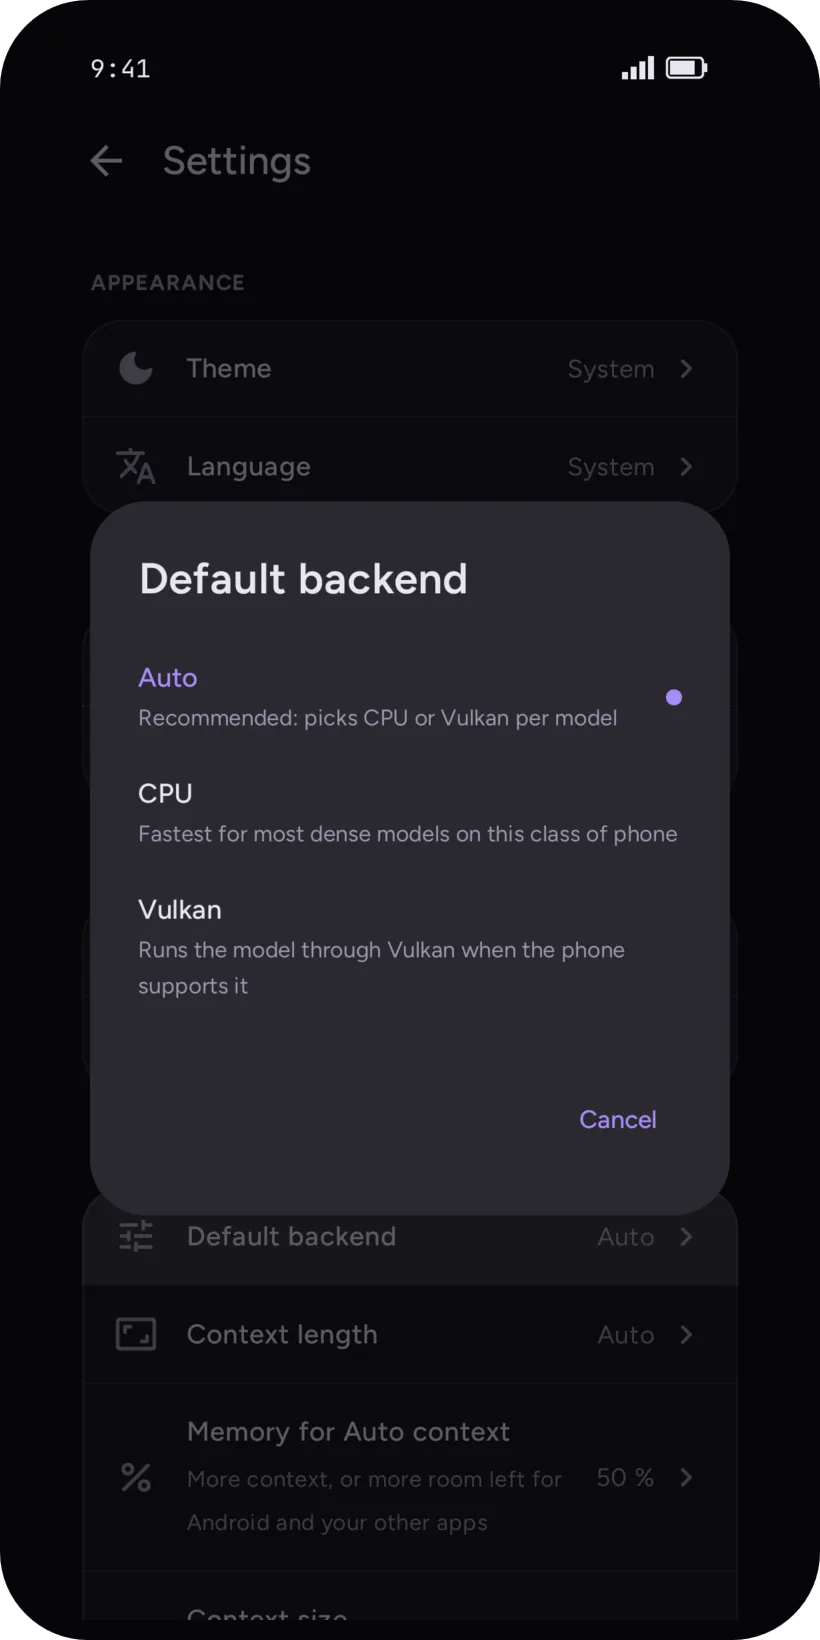
Paramètres, Inférence, Backend par défaut : Auto choisit CPU ou Vulkan par modèle, CPU force le processeur, Vulkan fait tourner le modèle sur le GPU quand le téléphone le gère. Auto est le choix recommandé.
Sur la classe de téléphone mesurée, les modèles denses (Llama, Qwen, Gemma) vont le plus vite sur les gros cœurs du CPU : ce GPU n'a pas de chemin cooperative-matrix, donc Vulkan perd en traitement du prompt comme en génération. Quelques architectures sont à l'inverse : pour Phi et Gemma 3n, le chemin CPU est lent et Vulkan génère plus vite, même si le CPU reste devant pour le traitement du prompt.
Mesuré sur un téléphone
Ton téléphone sera différent. Ce sont des chiffres, pas des promesses.
Dimensity 900 · Qwen3 1.7B Q4_K_M · CPU
- premier message une fois prêt
- ~1 s
- vitesse de réponse
- ~5,5 tok/s
- chargement du modèle
- ~7 s
La liste d'outils est préparée en arrière-plan après le chargement, environ une minute sur ce téléphone.
Les ~5,5 tok/s ci-dessus sont mesurés de bout en bout dans l'app. Ce tableau est le benchmark du moteur seul, celui de la page llama.kt : Qwen3-1.7B y fait 5,9 tok/s sur CPU, les deux diffèrent donc.
OPPO CPH2251 · Dimensity 900 (2× A78 à 2,4 GHz + 6× A55 à 2,0 GHz, Mali-G68 MC4, LPDDR4X) · Android 13 · nCtx 4096 · temp 0 · prompt d'environ 20 tokens · CPU = 2 threads sur les gros cœurs · llama.cpp b9769 · tok/s
| Modèle | Backend | pp | tg |
|---|---|---|---|
| Qwen2.5-0.5B-Instruct Q4_K_M | CPU(backend le plus rapide) | 29,5 | 15,0 |
| Vulkan | 7,0 | 9,0 | |
| Gemma-3-1B-it Q4_K_M | CPU(backend le plus rapide) | 10,9 | 6,0 |
| Vulkan | 3,7 | 5,4 | |
| Qwen3-1.7B Q4_K_M | CPU(backend le plus rapide) | 8,6 | 5,9 |
| Vulkan | 2,1 | 4,2 | |
| Llama-3.2-3B-Instruct Q4_K_M | CPU(backend le plus rapide) | 6,0 | 3,9 |
| Vulkan | 1,2 | 2,9 | |
| Phi-4-mini (3.8B) Q4_K_M | CPU | 3,9 | 1,7 |
| Vulkan(backend le plus rapide) | 0,8 | 2,3 | |
| Gemma-3n-E2B-it Q4_K_M | CPU | 1,9 | 1,1 |
| Vulkan(backend le plus rapide) | 1,8 | 1,9 | |
| Qwen2.5-7B-Instruct Q4_K_M | CPU | 1,4 | 0,2 |
Contexte et mémoire
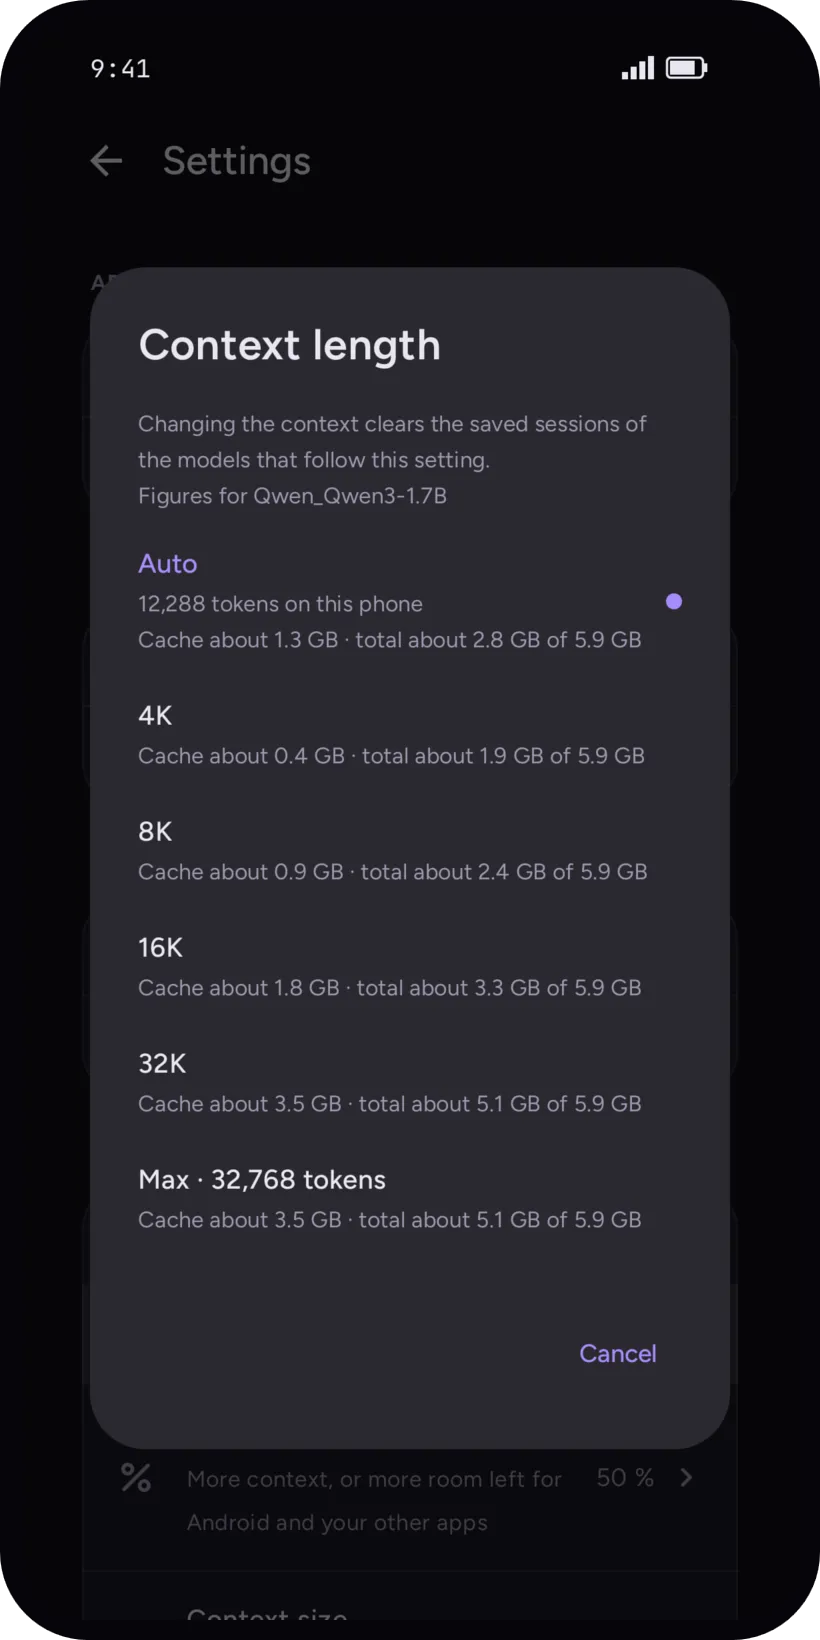
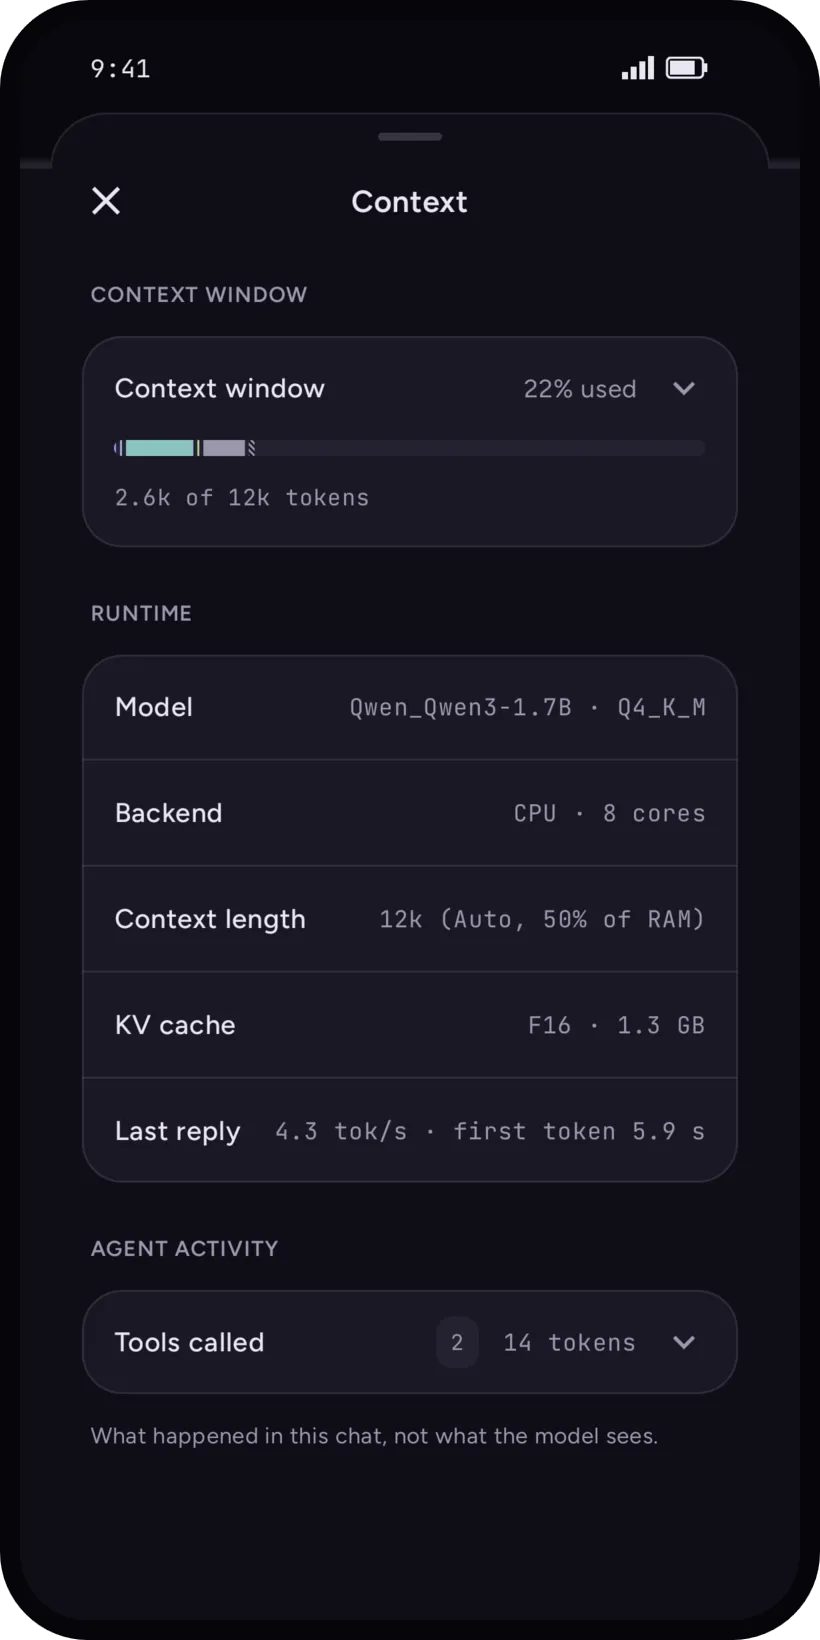
Le contexte, c'est ce que le modèle garde en tête dans une conversation. Il prend de la mémoire, dans un cache KV qui grandit avec sa longueur : un contexte plus long laisse moins de place au reste.
- Longueur de contexte
- Paramètres, Inférence. Auto, c'est le maximum que la mémoire de ton téléphone peut tenir, jusqu'à la longueur d'entraînement du modèle. 4K, 8K, 16K, 32K et Max sont des tailles fixes. Un modèle peut avoir son propre réglage.
- Mémoire pour le contexte Auto
- La part de la mémoire qu'Auto peut utiliser : plus de contexte, ou plus de place laissée à Android et à tes autres applis.
- Trop grand
- Si une taille est trop lourde pour le téléphone, tensai dit qu'il démarre plus bas. Il essaie d'abord un cache plus compact, puis des contextes plus petits.
Sur les chargements CPU, le cache mémoire est en q8_0 : les réponses sont plus rapides dans les chats avec outils (4,7 à 6,3 tok/s), mais la lecture d'un long texte nouveau est plus lente.
Changer le contexte efface les sessions sauvegardées des modèles concernés. Les conversations restent.
Quand c'est lent
- Prends un modèle plus petit. Un modèle Juste est plus lent par nature, voir le test d'adéquation.
- Regarde le backend du modèle dans le sélecteur, et essaie CPU ou Vulkan à la main.
- Baisse la longueur de contexte, ou la part de mémoire d'Auto.
- Ferme ce dont tu n'as pas besoin : le verdict passe aussi à Juste quand le téléphone manque de mémoire libre.
- Après le chargement d'un modèle, tensai prépare sa liste d'outils en arrière-plan : le premier message d'un nouveau chat peut l'attendre.
- Le premier message après une réponse créative, qui tourne sans outils, n'attend plus une relecture complète du préfixe des outils : environ 2 minutes avant, 1 à 2 s maintenant (Dimensity 900, Qwen3-1.7B sur CPU), y compris après la réouverture de l'app.