DocsModèles
Choisir son premier modèle
Commence petit. Un modèle qui tient large est plus rapide et plus utile qu'un gros qui charge à peine.
Commencer petit
Au premier lancement, tensai propose le plus gros modèle de sa liste intégrée qui fonctionne bien sur ton téléphone, jugé sur ta RAM, ou le plus petit si aucun ne convient. Les autres modèles de la liste sont dessous, chacun avec son verdict.
Les modèles de 1 à 2 milliards de paramètres sont les plus à l'aise. Monte quand tu sais comment ton téléphone les encaisse.
Le fichier à chercher
Les modèles sont des fichiers GGUF. Le nom du fichier dit le modèle, sa taille et sa compression.
Qwen_Qwen3-1.7B-Q4_K_M.ggufLire le nom
- Qwen3
- La famille du modèle.
- 1.7B
- Les paramètres, en milliards. Plus il y en a, plus le modèle est malin, et lent.
- Q4_K_M
- La quantification : à quel point les poids sont compressés. C'est celle de tous les modèles de la liste intégrée de tensai.
Taille et mémoire
Le verdict de l'app pour quelques modèles, selon la RAM du téléphone. Ton téléphone a aussi besoin de place pour la conversation elle-même : un modèle juste ralentit quand les chats s'allongent.
| Modèle | Taille du fichierTaille | 4 Go RAM | 6 Go RAM | 8 Go RAM |
|---|---|---|---|---|
| Qwen3 1.7B Q4_K_M | 1,28 Go | Fonctionne bien | Fonctionne bien | Fonctionne bien |
| Llama 3.2 3B Q4_K_M | 2,02 Go | Ne tiendra pas | Fonctionne bien | Fonctionne bien |
| Qwen3 4B Q4_K_M | 2,50 Go | Ne tiendra pas | Juste | Juste |
| Modèle de classe 8B, Q4 | 4,50 Go | Ne tiendra pas | Ne tiendra pas | Juste |
La ligne 8B est un fichier typique de cette classe, pas un modèle de la liste de tensai.
Les téléphones de 4 Go sont à la limite. Le tableau décrit une classe de téléphone : l'app vérifie ton vrai téléphone et le vrai fichier.
Le test d'adéquation
Chaque modèle reçoit un voyant, calculé sur ton téléphone avec des chiffres que l'app peut lire : ta RAM totale, et le fichier et la forme du modèle.
- Mémoire utilisable
- Ta RAM totale moins 1,5 Gio, gardés pour Android et tes autres applis.
- Ce dont un modèle a besoin
- Son fichier, plus environ 300 Mio de tampons de travail, plus un tampon et un cache KV qui grandissent avec le contexte. Avec le contexte Auto, le verdict le chiffre à 4096 tokens, ou à la longueur d'entraînement du modèle si elle est plus courte, avec un cache en F16. Avec une taille fixe ou Max, il prend le plan que le chargement suivrait vraiment.
- Fonctionne bien
- Il tient dans la mémoire utilisable et ne devrait pas être lent.
- Juste
- Il charge, mais il demande plus que la mémoire libre à cet instant, ou il devrait être lent : les modèles de 3,5 milliards de paramètres ou plus, et les familles Gemma 3n et Gemma 4, sont marqués juste même quand ils tiennent.
- Ne tiendra pas
- Il demande plus que la mémoire utilisable. Pour un fichier importé, même le plus petit contexte auquel le chargement peut descendre (1024 tokens) ne tient pas.
Deux autres étiquettes existent : Non pris en charge, quand le moteur ne connaît pas encore l'architecture du modèle, et Modèle brouillon, pour les têtes de décodage spéculatif qui ne tournent pas seules. Aucune des deux ne peut se charger.
Un voyant rouge n'interdit rien : Charger quand même est là, discret exprès. Dans la fiche du modèle, Mémoire estimée montre le chiffre derrière le voyant.
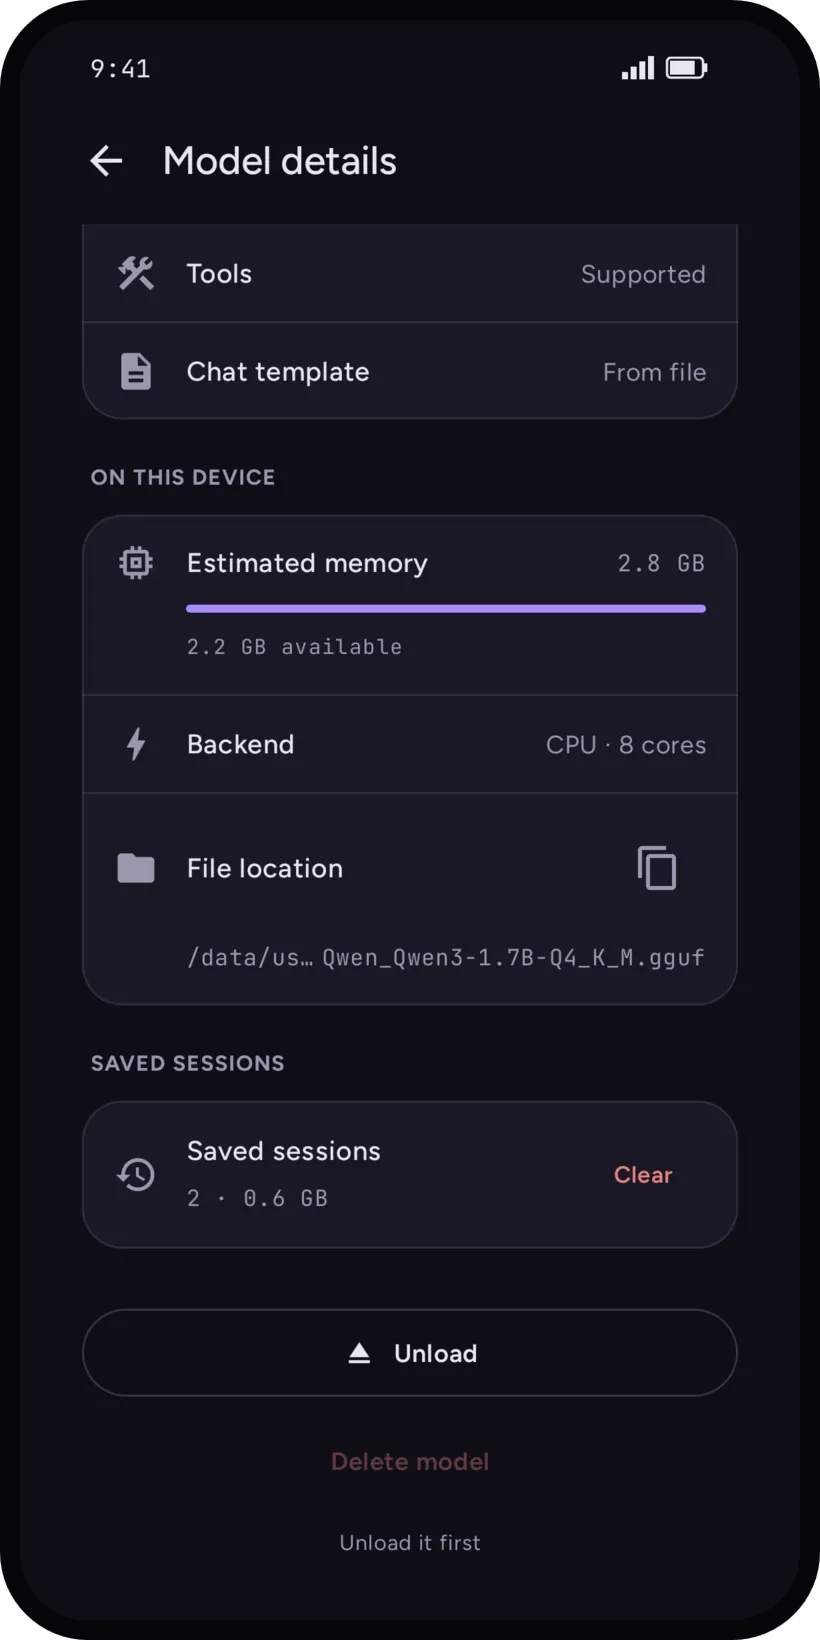
Dans l'app
Ouvre le sélecteur de modèle depuis la puce de la barre de saisie. Chaque modèle montre sa quantification, la taille du fichier, le backend et l'adéquation pour ce téléphone. Gérer les modèles et Découvrir des modèles sont sous la liste.
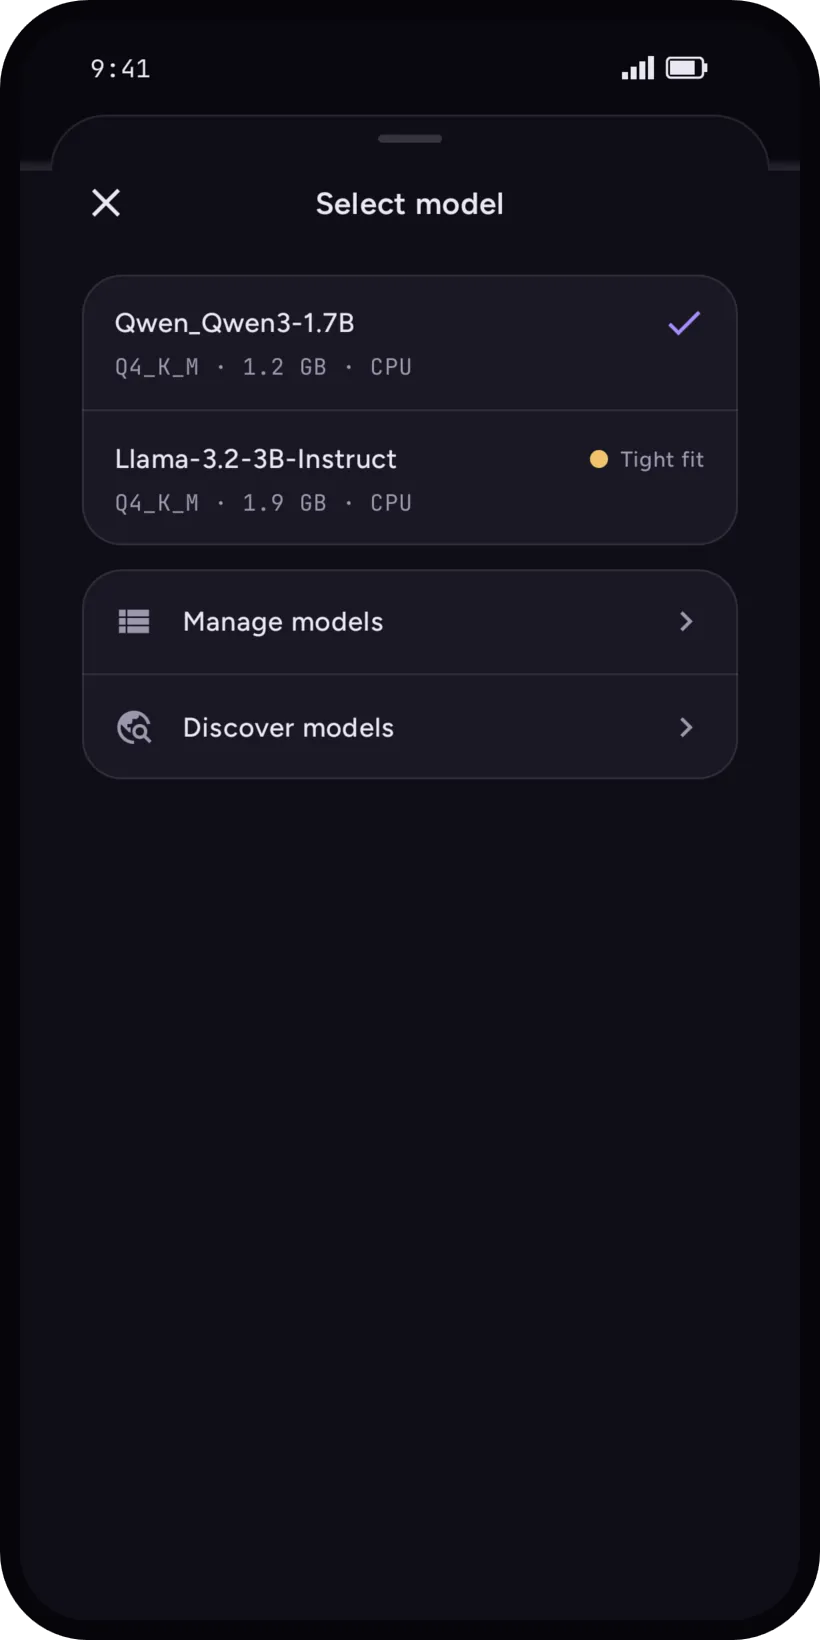
Dans Découvrir, Recommandés pour cet appareil vient en premier, et le filtre Tient sur mon téléphone cache ce qui ne chargerait pas. Voir Télécharger depuis Hugging Face.