Ton téléphone, ton IA.
tensai fait tourner des modèles ouverts directement sur le téléphone Android. Chat, raisonnement et un agent capable d'agir, sans que rien ne quitte l'appareil sauf demande explicite.
Pré-1.0, des changements à prévoir
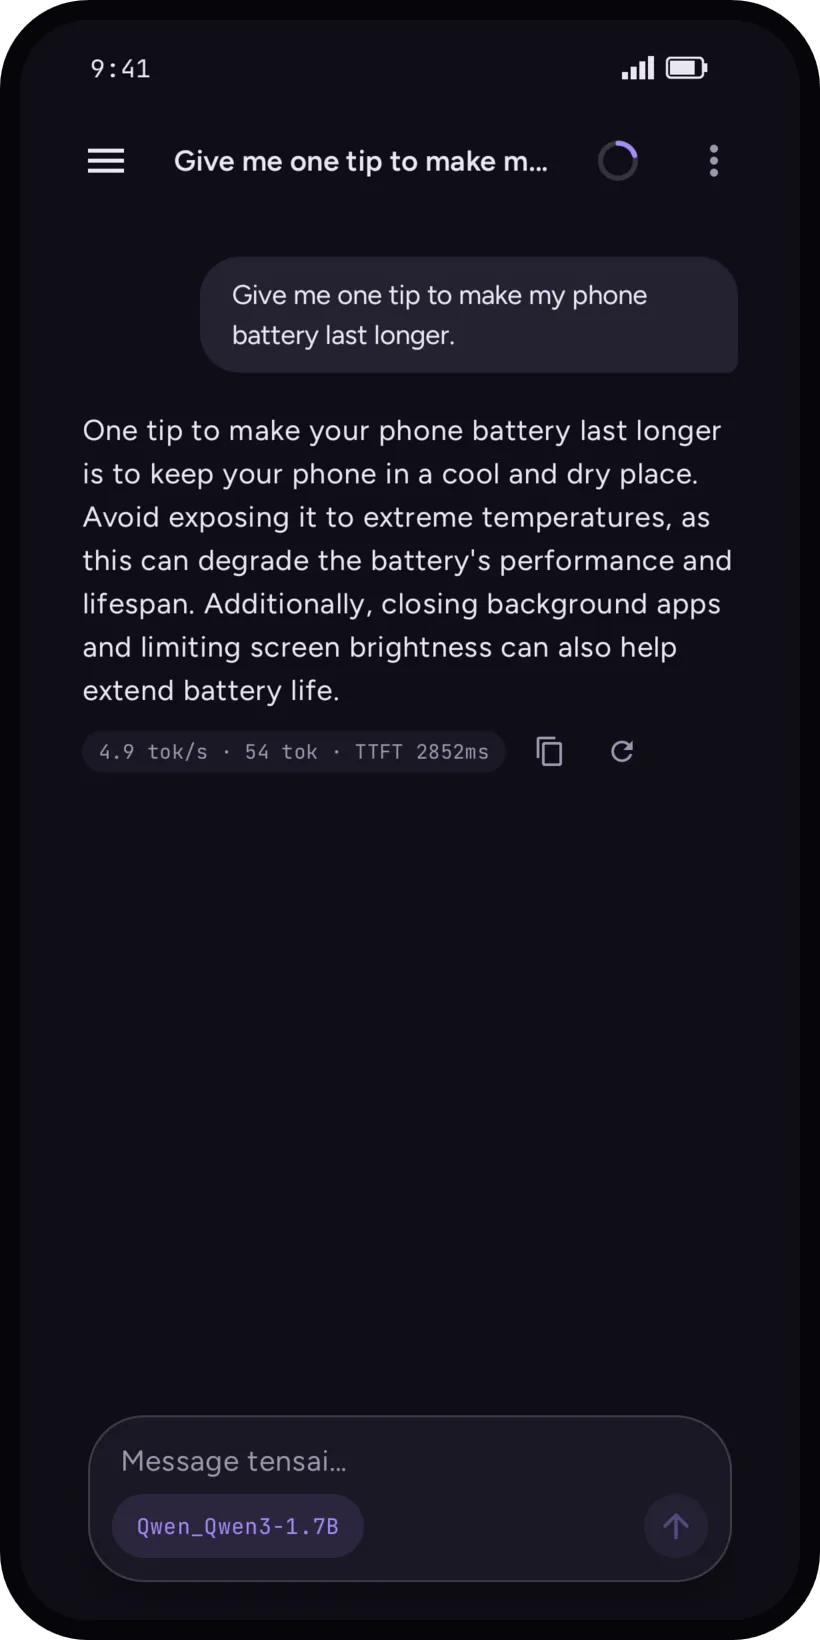
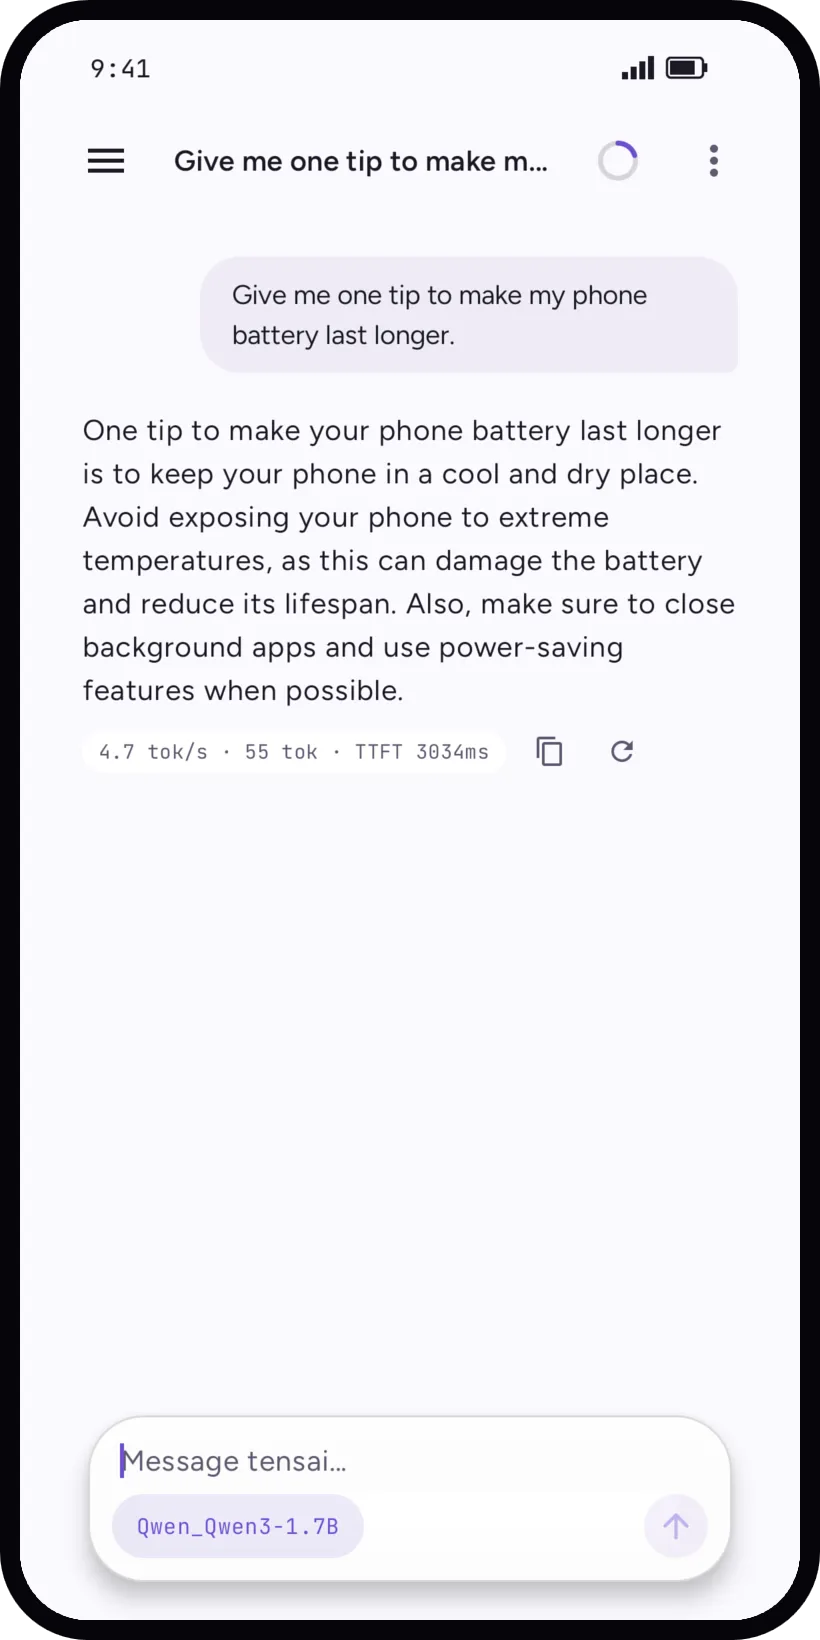
Sur l'appareil
Les modèles tournent sur le CPU ou le GPU du téléphone, via llama.cpp. Une fois un modèle téléchargé, tensai fonctionne hors ligne.
Tout modèle ouvert
Importer un fichier GGUF ou en choisir un sur Hugging Face. Un test d'adéquation le compare à la mémoire du téléphone.
- Passe bien
- Juste
- Ne passe pas
Un agent, avec des garde-fous
Des outils pour les dates, le calcul, la mémoire, les minuteurs, l'agenda et les messages. Tout ce qui envoie ou supprime demande confirmation. Les outils Internet restent désactivés tant qu'ils ne sont pas activés.
À quoi ça ressemble
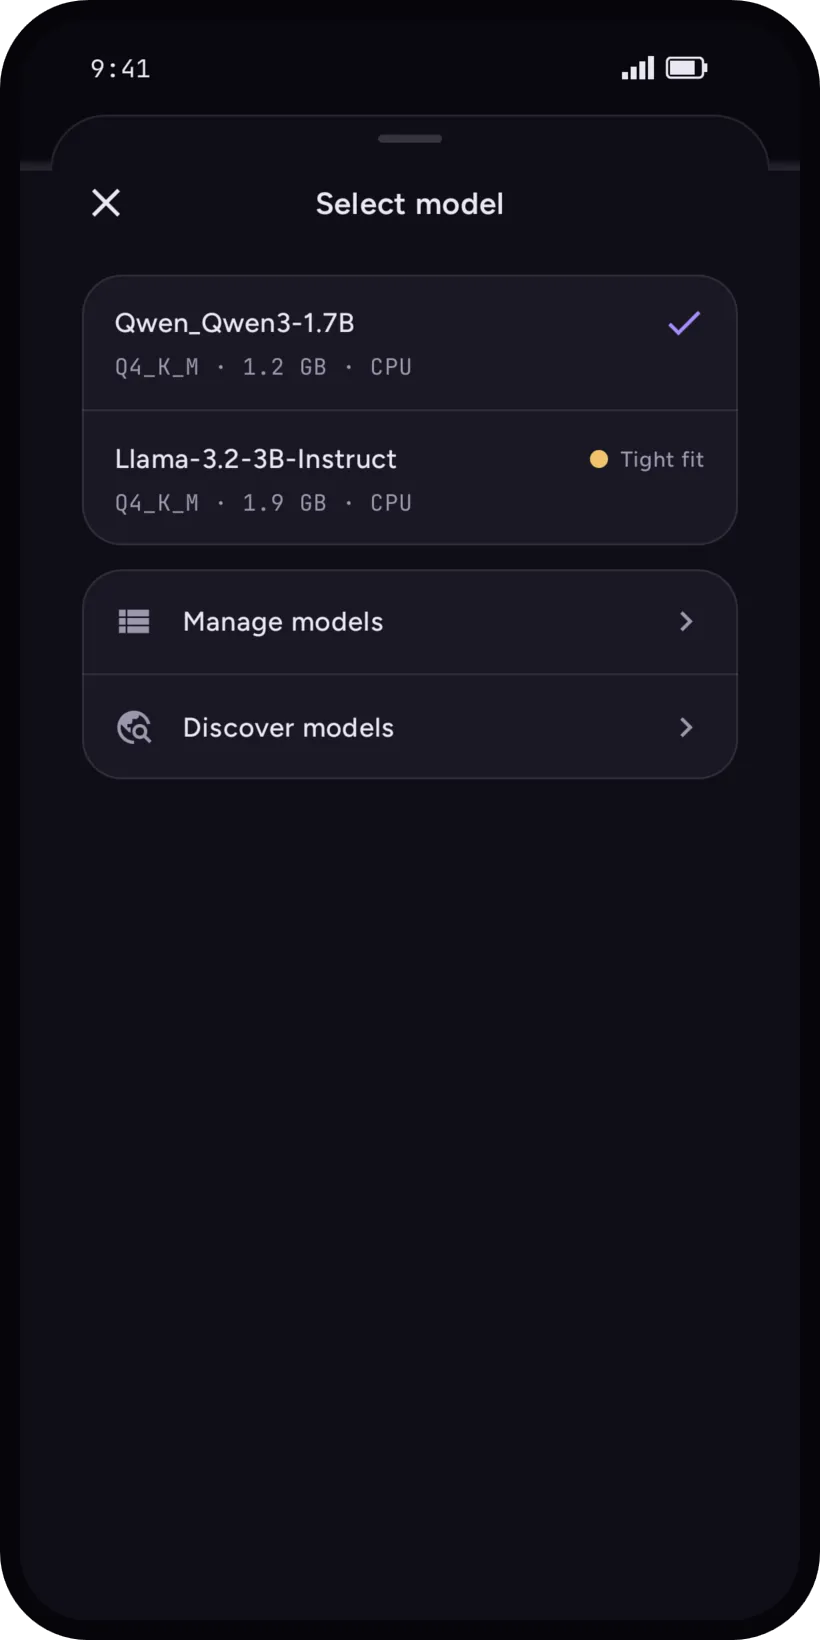
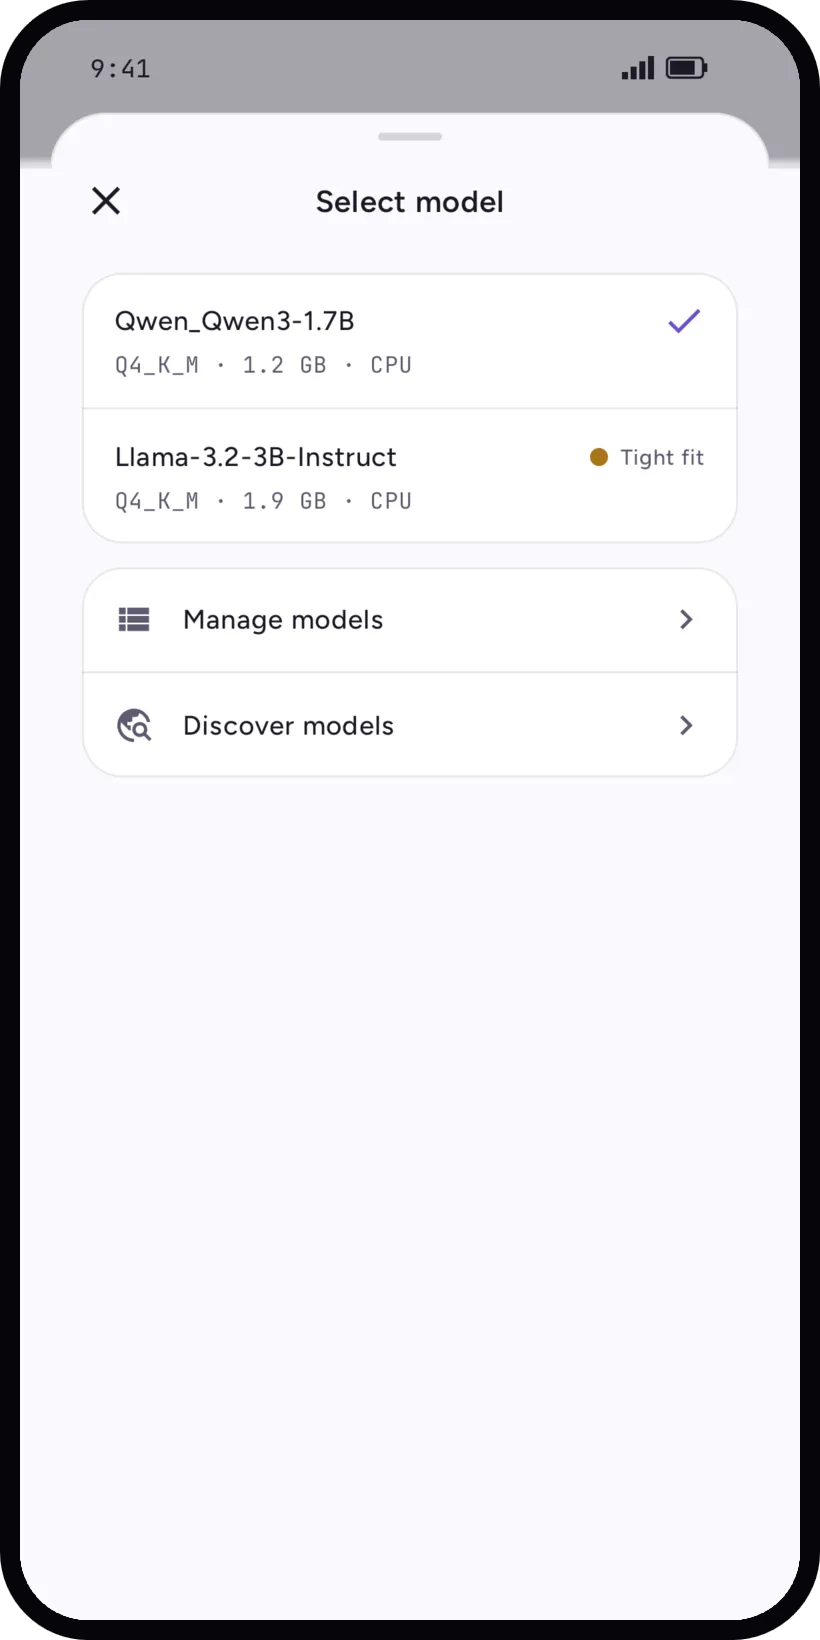
Choisir un modèle. Le test d'adéquation montre ce que le téléphone peut faire tourner. 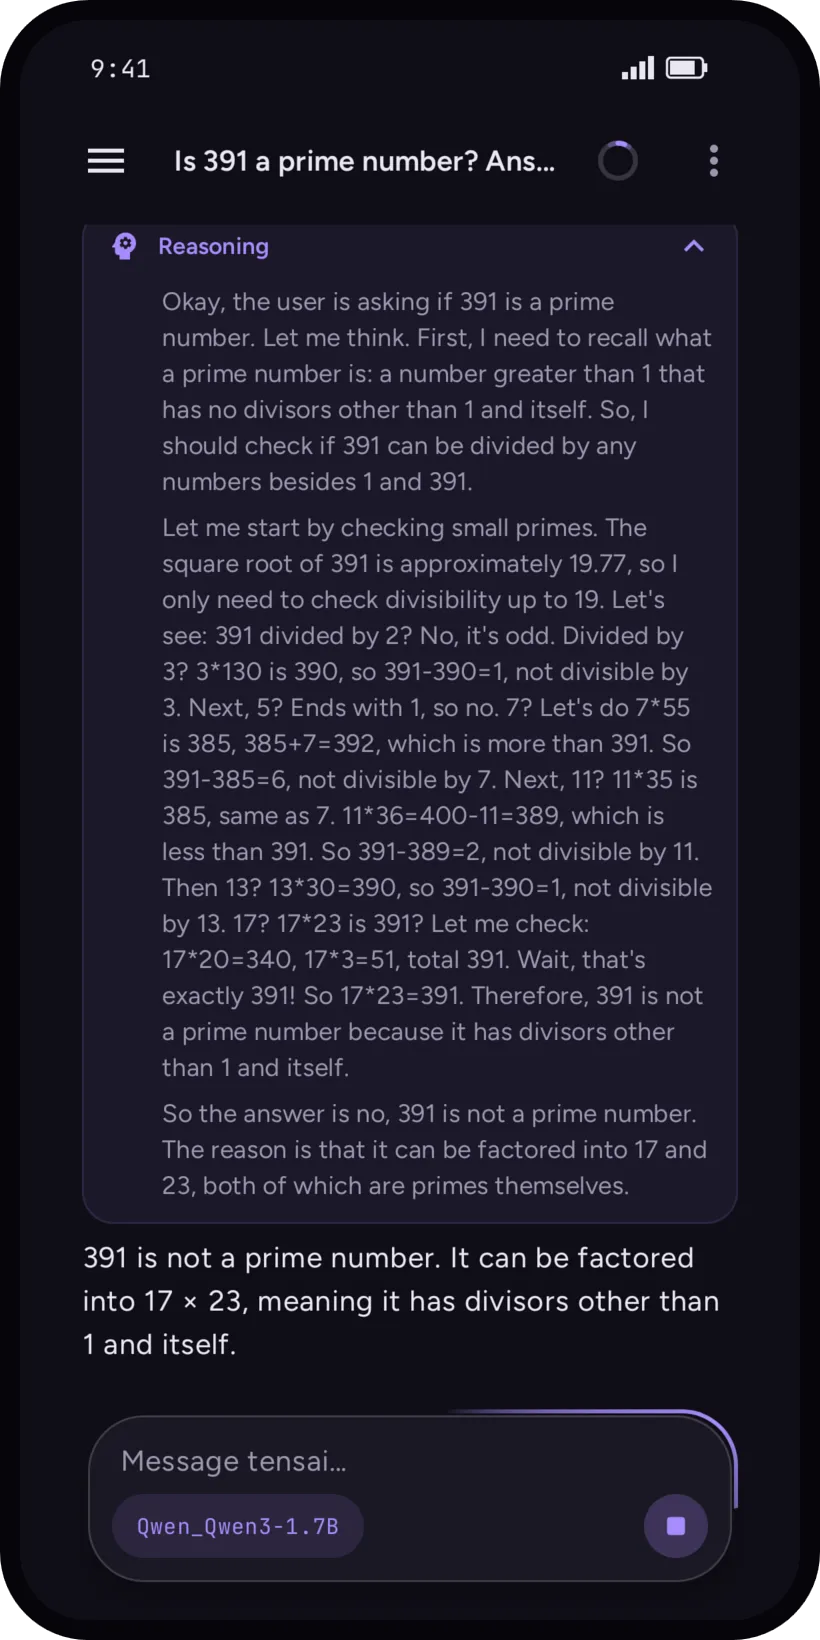
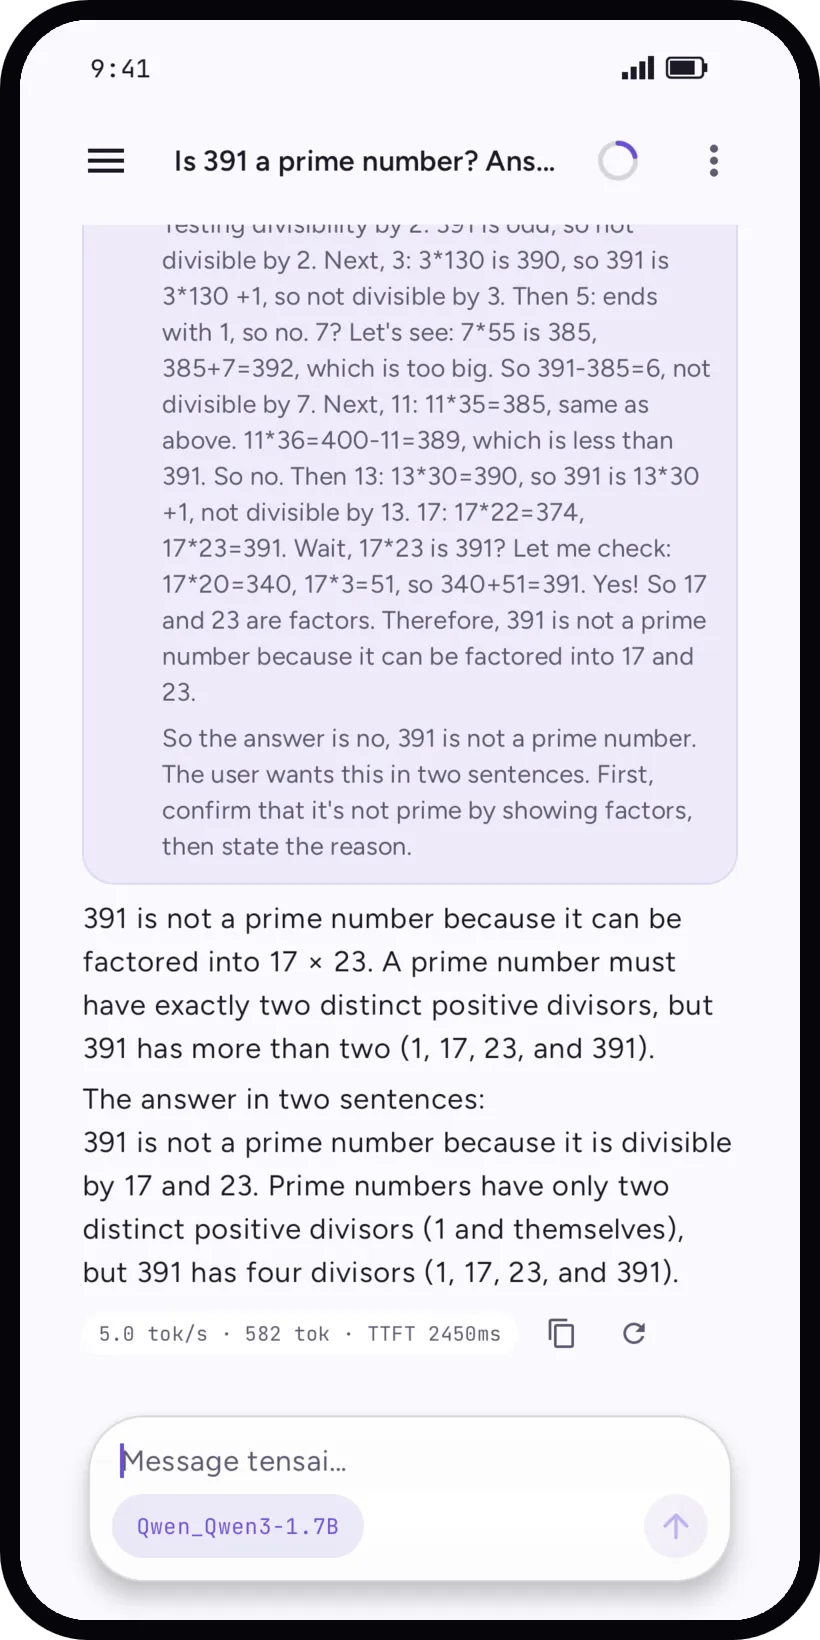
Lire le raisonnement du modèle, ou le replier. 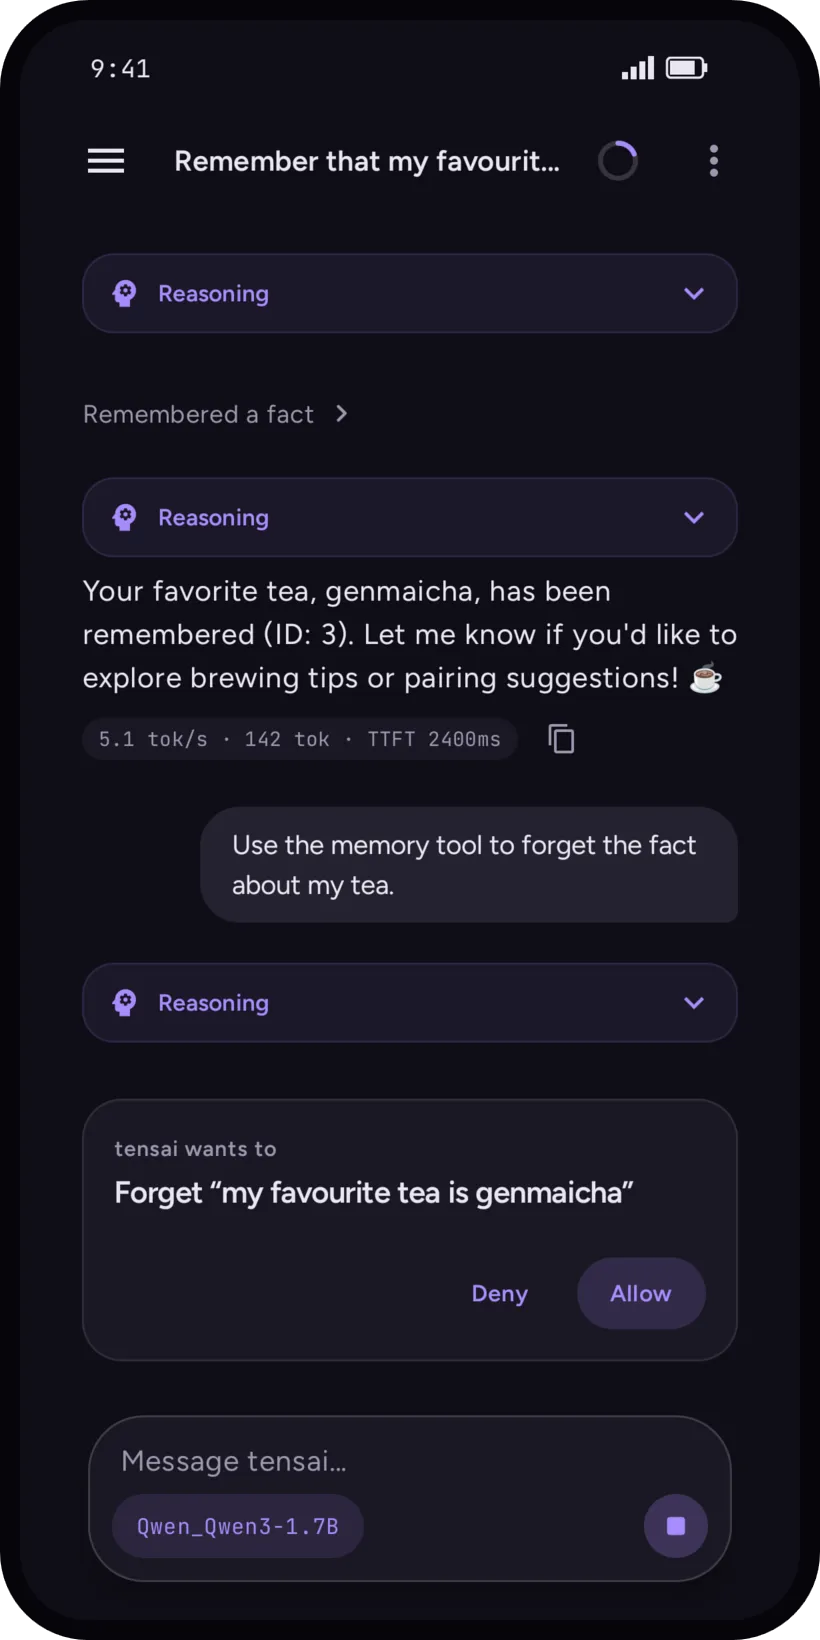
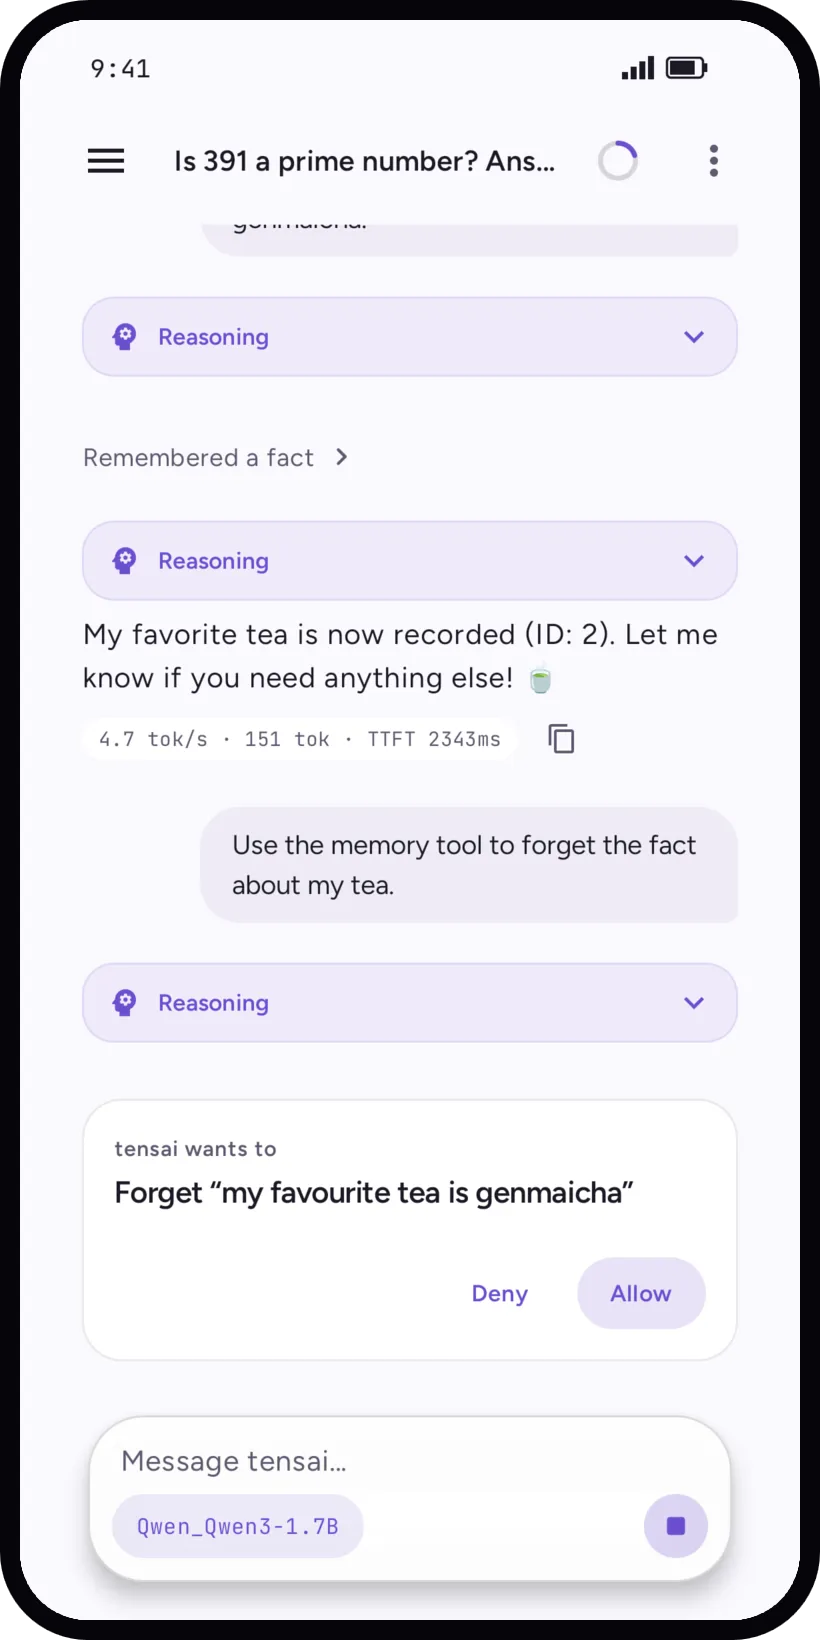
Tout ce qui supprime ou envoie attend une réponse. 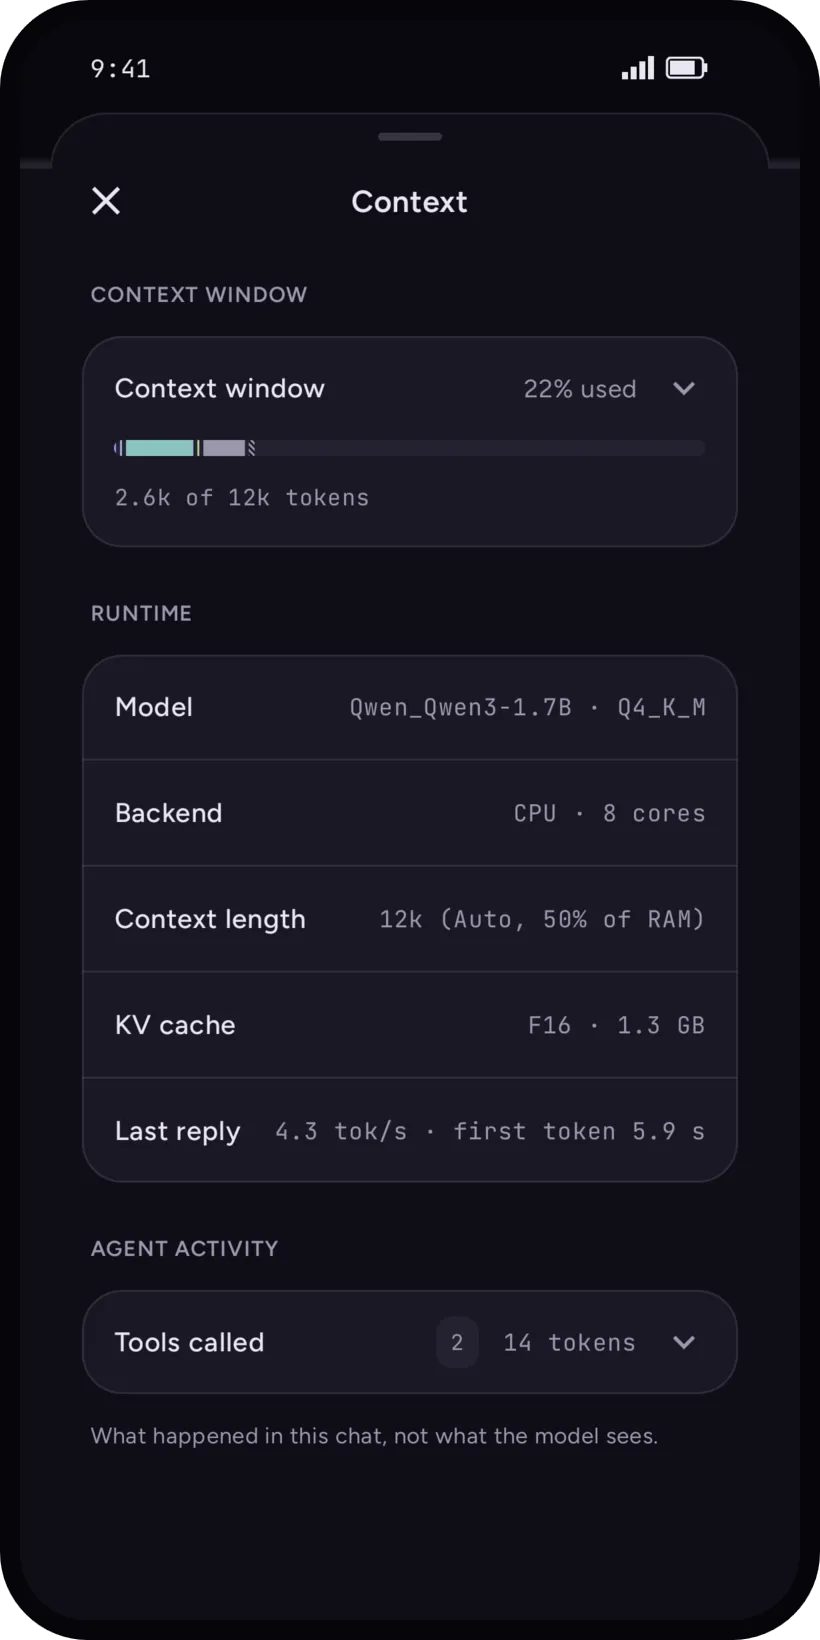
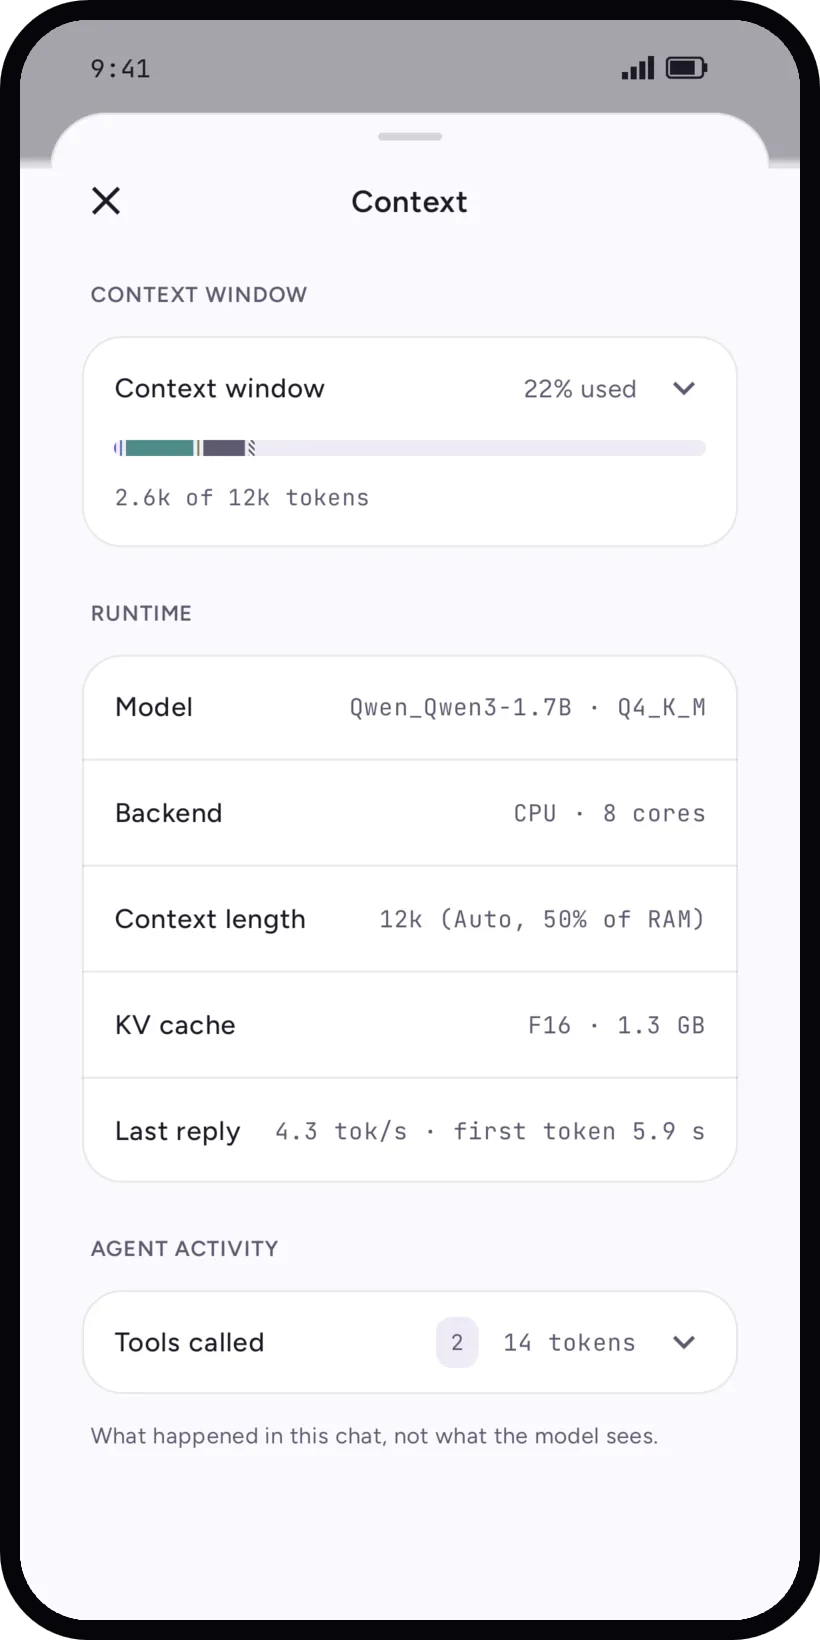
Voir ce qui remplit le contexte, activité de l'agent comprise.
Mesuré
Les résultats varient selon le téléphone. Les gros modèles sont lents sur un téléphone : tensai prévient avant le téléchargement.
Dimensity 900 · Qwen3 1.7B Q4_K_M · CPU
| premier message une fois prêt | ~1 s |
|---|---|
| vitesse de réponse | ~5,5 tok/s |
| chargement du modèle | ~7 s |
La liste d'outils est préparée en arrière-plan après le chargement, environ une minute sur ce téléphone.
La suite
- MCP et skills
- 1.0 : version stable
- Serveur d'API sur le réseau local
Apache 2.0. L'app et le moteur, llama.kt, sont sur GitHub.